AI芯片设计 创新浪潮下的挑战与未来之路

在人工智能技术席卷全球的今天,AI芯片作为承载算力的核心硬件,正经历着前所未有的创新浪潮。从云端训练到边缘推理,从通用GPU到专用ASIC,芯片架构的演进不断突破性能与能效的边界。随着AI模型参数规模的指数级增长以及应用场景的日益多元化,AI芯片设计面临着模型复杂性、软硬件协同等多重挑战。这些挑战也恰恰孕育着设计范式变革的机遇。
一、创新不断:AI芯片设计的现状与动力
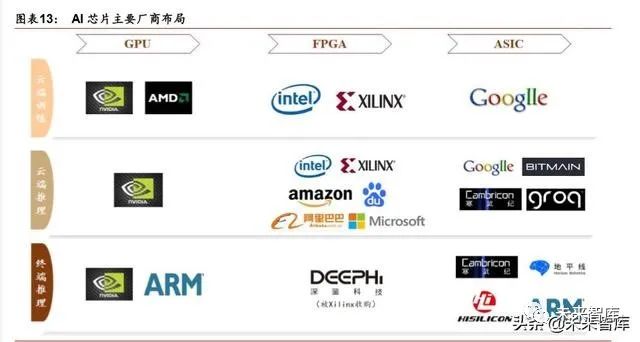
当前AI芯片设计的创新主要体现在三个层面。其一,架构多样化。除了传统的CPU、GPU,谷歌TPU、华为昇腾、寒武纪思元等专用芯片采用脉动阵列、存内计算等新型架构,针对矩阵运算和卷积操作进行极致优化,能效比提升数倍。其二,制程与封装进步。台积电3nm、三星2nm工艺以及Chiplet小芯片设计,使得单芯片可集成数百亿晶体管,并通过高带宽互连提升数据吞吐。其三,领域定制化。针对大语言模型、自动驾驶、科学计算等不同场景,芯片设计开始从“通用”走向“专用+可编程”的平衡。这些创新的根本驱动力,来自AI模型规模与算力需求的爆炸式增长。
二、核心挑战:模型复杂性与软硬件协同
尽管创新不断,AI芯片设计仍面临两大核心挑战。
挑战一:模型复杂性带来的设计压力。 自Transformer架构普及以来,AI模型参数量从百万级跃升至万亿级。GPT-4、PaLM等超大模型要求芯片具备极高的内存带宽和片间互连能力,同时推理时的稀疏化、量化需求又要求芯片灵活支持混合精度。多模态模型、动态神经网络等新型结构打破了传统规则的计算模式,对芯片的可编程性和适应性提出了更高要求。传统“一刀切”的硬件设计已难以为继,设计者必须在通用性与专用性之间找到新的平衡点。
挑战二:软硬件协同的鸿沟。 芯片性能的发挥高度依赖软件栈——编译器、驱动、算子库和框架。当前硬件设计往往先于软件成熟,导致开发者难以充分利用芯片潜力;反之,软件生态的碎片化(如不同厂商的编程模型互不兼容)又拖慢了硬件迭代。例如,CUDA生态的强势地位使其他芯片难以渗透,而新兴的RISC-V AI加速器则面临软件工具链薄弱的困境。软硬件协同设计(HW/SW Co-design)要求从早期阶段就并重考虑算法、编译与架构,但跨学科团队的协作效率和设计自动化水平仍有待提升。
三、未来展望:AI芯片设计的可能路径
面对上述挑战,AI芯片设计的未来有望沿以下方向继续突破。
1. 架构创新:从计算到存储的范式转移。 存内计算(Processing-in-Memory)和近存计算将计算单元嵌入存储阵列,大幅减少数据搬运能耗,尤其适合 Transformer 这类访存密集型模型。光计算、量子计算等新兴技术虽处早期阶段,但长期看可能颠覆传统电子芯片的能效极限。
2. 软硬件协同设计方法的普及。 借助机器学习自动搜索最优的芯片架构与编译策略(如AutoTVM、混合精度量化感知训练),结合领域特定语言(DSL)和可重构数据流架构,可以实现“算法-编译-硬件”的闭环优化。芯片设计工具将更加智能化,能够根据目标模型自动生成定制化加速器。
3. 开放指令集与生态共建。 RISC-V凭借其开放性和可扩展性,正成为AI加速器的新选择。通过建立统一的软件接口和算子标准(如OpenXLA、MLIR),不同硬件厂商有望打破生态壁垒,让开发者一次编程即可跨平台部署。
4. 系统级集成与云边端协同。 AI芯片将不再孤立存在,而是通过Chiplet、先进封装和高速互连形成系统级解决方案。云端训练芯片与边缘推理芯片需在模型压缩、联邦学习等层面协同,实现算力资源的动态调度。
四、
AI芯片设计正处于一个充满机遇与挑战的十字路口。模型复杂性的提升倒逼硬件架构持续创新,而软硬件协同的深化则是释放芯片潜能的关键。我们有理由相信,通过存内计算、自动化设计工具、开放生态和系统级集成等多条路径的协同推进,AI芯片将不仅能跟上模型演进的步伐,更有可能反过来推动AI算法与应用的新突破。在这一进程中,跨学科合作与开源精神将成为不可或缺的驱动力。
如若转载,请注明出处:http://www.todayiots.com/product/21.html
更新时间:2026-10-31 02:17:15