英伟达H100 引领生成式人工智能设计的计算机芯片
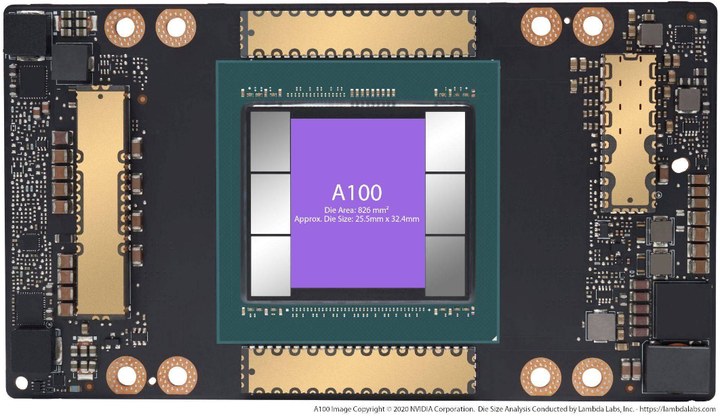
在人工智能技术迅猛发展的浪潮中,生成式人工智能(Generative AI)正以前所未有的速度重塑内容创作、科学研究和商业应用的格局。而支撑这一切的核心引擎,便是英伟达(NVIDIA)推出的H100 Tensor Core GPU。这款专为大规模AI计算设计的计算机芯片,正以其卓越的性能和创新的架构,引领着生成式人工智能设计的全球潮流。
突破性的架构设计
英伟达H100基于全新的Hopper架构,集成了800亿个晶体管,采用台积电4N定制工艺。其最显著的特点是引入了Transformer引擎,专门针对生成式AI模型(如GPT系列、BERT等)的核心运算进行优化。Transformer引擎能够动态选择FP8或FP16精度,在保持模型精度的同时大幅提升计算吞吐量,使得训练万亿参数级别的语言模型成为可能。H100还配备了第四代NVLink和PCIe 5.0,实现了GPU间的高速互联,为分布式训练提供了坚实的通信基础。
性能飞跃:从训练到推理
在生成式AI领域,训练和推理是两个关键阶段。H100在两者均展现出惊人的性能提升。据英伟达官方数据,H100在训练大型语言模型时,吞吐量较上一代A100提升了9倍,而在推理任务中,借助Transformer引擎和新的DPX指令集,性能提升高达30倍。这意味着企业和研究机构能够以更低的成本和更短的时间,完成复杂生成模型的训练与部署,从而加速AI创新的迭代周期。例如,在BERT模型训练中,H100仅需不到一周即可完成,而A100需要数月之久。
推动全球创新生态
H100的推出不仅是一次硬件升级,更在全球范围内激发了AI创新生态的活力。从云服务提供商(如AWS、Azure、Google Cloud)到AI初创公司,再到国家级超算中心,H100已成为生成式AI基础设施的首选。它支撑着ChatGPT、Midjourney、Stable Diffusion等热门应用的背后计算,同时也为药物发现、气候模拟、金融建模等领域带来突破。英伟达通过CUDA和AI Enterprise软件栈,降低了开发者使用门槛,使得全球研究者和工程师能够更专注于算法与模型创新,而非底层优化。
能效与可持续性
面对AI计算日益增长的能耗挑战,H100在性能提升的也注重能效优化。其采用的多实例GPU(MIG)技术允许将单块GPU分割为多个独立实例,提高资源利用率;而动态功耗管理则根据负载调整频率,降低闲置能耗。与CPU方案相比,H100在完成相同AI任务时能耗可降低数倍,助力绿色AI发展。
##
英伟达H100作为生成式人工智能设计的旗舰芯片,凭借其架构创新、性能突破和生态整合,正引领着全球AI计算的新纪元。它不仅解决了大规模模型训练与推理的算力瓶颈,更通过软硬件协同设计,推动了AI技术的民主化进程。随着生成式AI向多模态、更复杂的方向演进,H100及其后续产品将继续扮演核心角色,驱动全球创新迈向新的高度。
如若转载,请注明出处:http://www.todayiots.com/product/43.html
更新时间:2026-10-31 13:34:21